引言
随着端側AI推理應用的不斷深入,RK3588憑借其強大的多媒體處理能力和通用計算性能,已成為嵌入式邊緣計算領域的明星平台。然而,其内置NPU僅6TOPS的算力在面對Qwen等大模型的高負載推理時,逐漸暴露出性能瓶頸。在運行3B及以上的模型時,推理速度明顯變慢,難以滿足日益增長的實時性需求。
正是在這一背景下,瑞芯微于2025年推出了RK1828端側AI協處理器。該芯片采用M.2 2280标準形态,通過PCIe接口與主控平台高速互聯,可實現即插即用式的算力擴展。RK1828搭載專用NPU,INT8峰值算力高達20TOPS,并内置5GB 3D堆疊高帶寬DRAM,專門承接高負載AI推理任務。憑借“主控統籌+協處理器專職加速”的異構架構,RK3588與RK1828的組合正成為邊緣AI大模型産品極具競争力的硬件底座。
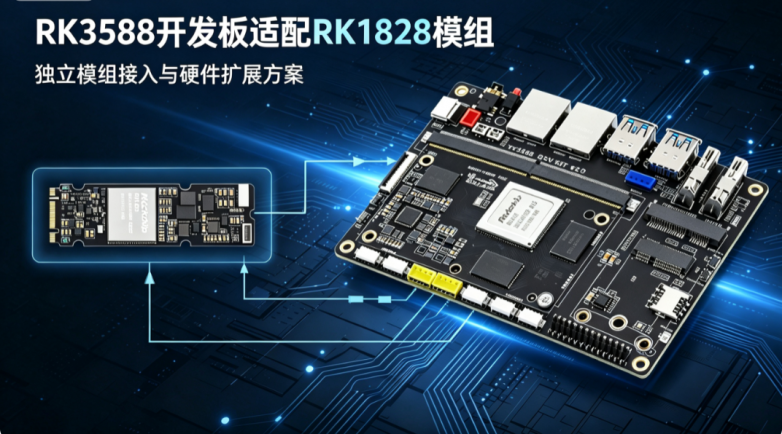
本文将從硬件平台搭建、系統軟件适配到推理性能驗證,完整記錄RK3588開發闆上适配RK1828 M.2模組的全過程,并通過大模型對話的實測數據,直觀展示RK1828相比RK3588自帶NPU的性能提升幅度。
硬件平台搭建
硬件選型
本文選用的主控平台為風火輪技術推出的YY3588開發闆。該開發闆基于瑞芯微RK3588芯片打造,采用核心闆+底闆的模塊化設計,核心闆尺寸為82mm×53mm,默認底闆尺寸為120mm×88mm,兼具高性能與緊湊體積。RK3588搭載八核64位CPU(4×Cortex-A76@2.4GHz + 4×Cortex-A55@1.8GHz),集成6TOPS NPU,适合工業控制、邊緣AI等多元化應用場景。
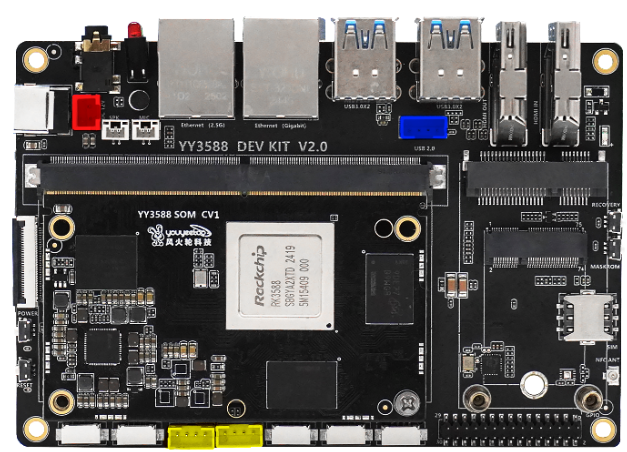
YY3588開發闆闆載一路M.2 M-Key接口,支持NVMe 2280 SSD固态硬盤,走PCIe 3.0總線。該接口可直接接入本次适配的RK1828 M.2模組。
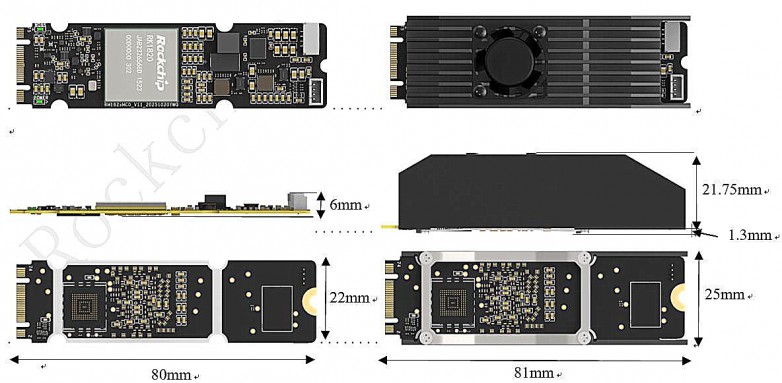
AI協處理器模組選用瑞芯微RM182XMC0。該模組采用M.2 Key B-M連接器,物理尺寸為22mm×80mm×6mm。模組内置RK1828協處理器芯片,基于三核64位RISC-V架構,搭載專用NPU引擎,INT8峰值算力高達20TOPS,并内置5GB高帶寬DRAM。模組支持PCIe 2.1接口,單 Lane 運行,數據傳輸速率最高可達5.0Gbps。此模組形态如下
硬件安裝步驟
步驟一:檢查接口兼容性。确認YY3588開發闆的M.2插槽為M-Key規格,支持PCIe 3.0信号。RK1828模組采用Key B-M連接器,兩者在物理接口和電氣信号上兼容。
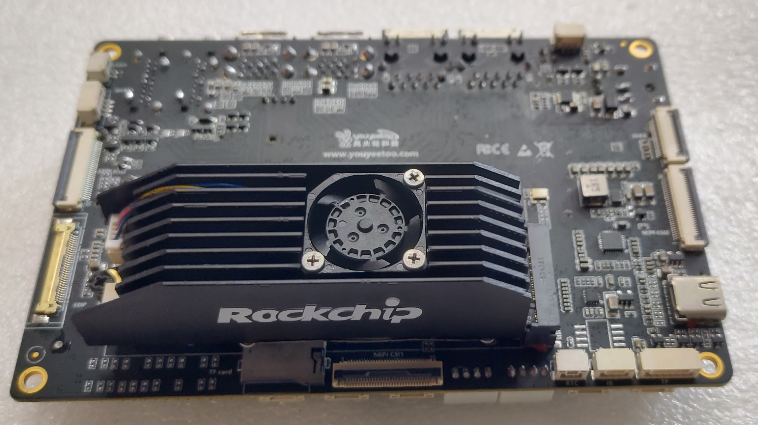
步驟二:安裝模組。 将RK1828模組的金手指對準YY3588開發闆的M.2插槽,使用配套螺絲将其固定于底闆上的銅柱螺孔。
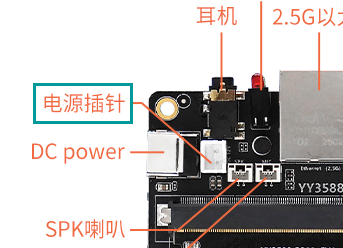
步驟三:連接供電。 RK1828模組需要獨立的12V主供電輸入。根據規格書,VCC_IN供電電壓範圍為8.0V至14.4V,典型值為12.0V;3.3V供電電壓範圍為2.97V至3.63V,典型值為3.3V。YY3588上面有一個電源插針,在下圖所示的位置,此電源插針和DC電源座是通的,将RM182XMC0配套電源線插到這個座子上面即可。
步驟四:上電啟動。 完成上述安裝後,為YY3588開發闆上電,系統正常啟動。此時,RM182XMC0上面的風扇也會轉動。
硬件識别驗證
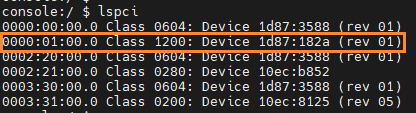
系統啟動後,可在YY3588開發闆的串口通過以下命令驗證RK1828模組是否被正确識别:
lspci
預期輸出中應出現VID為1d87 PID為182a的設備
常見問題排查
1、RM182XMC0風扇不轉,指示燈不亮
檢查12V電源是否接反,電源電流是否足夠。預留給RK1828模組應至少達到2A,不然可能出現不開機的情況。
2、RM182XMC0上電,PCIE不識别
檢查一下dmesg裡面是否有報錯信息,正常情況下,會是這樣的信息
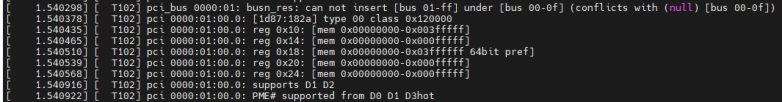
如果枚舉失敗,有可能是接觸不良
完成硬件識别驗證後,即可進入下一階段的系統軟件适配工作。
軟件适配(基礎部署)
系統軟件層面的适配工作,主要包括内核驅動配置、RK1828固件與運行時庫的安裝部署,以及環境驗證。本章基于瑞芯微官方提供的RK1820/RK1828 AI SDK(Release V1.1.0)進行說明。此SDK框架如下圖所示
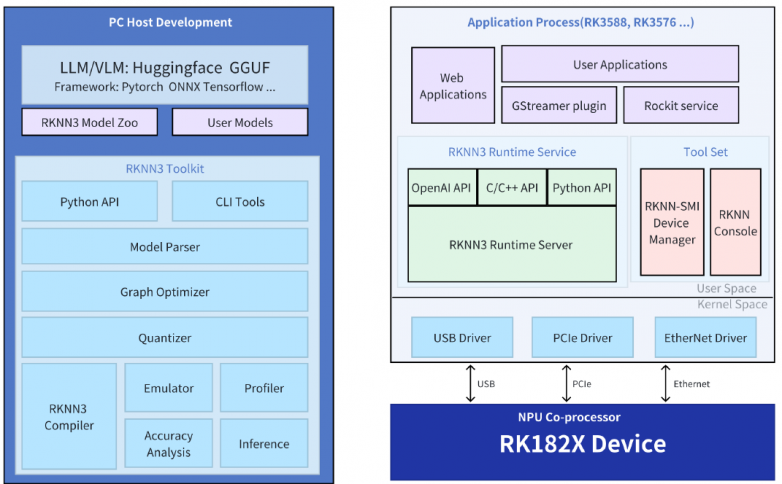
此SDK框架與RK3588上面運行的RKNN2有相似之處,都包含了PC端的RKNN Toolkit與主控端的RKNN Runtime。不同的是,使用RK1828時,還需要主控加載USB/PCIe/Ethernet驅動,與RK1828通信。使用這個M.2接口的RK1828模塊時,使用的是PCIe通道。
系統與環境準備
Host端系統要求:本文使用的YY3588開發闆,開發闆上安裝android系統。要使用RK1828的PCIE驅動,要求内核版本需不低于5.10。
SDK獲取:從瑞芯微官方渠道獲取RK1828 M.2模組對應的預編譯軟件安裝包 rknn3_rk182x_m2_v1.1.0_installer_arm64.tgz。該安裝包包含了RK1828固件、RKNN3 Runtime、調試工具集(rknn-smi、rknn-console)等。
内核驅動配置
内核驅動配置有如下兩個方法,任選其一
1、若需自行編譯内核以啟用PCIe EP功能支持,需在Rockchip SDK内核源碼中确認已合入相關補丁,對于Linux kernel 6.1版本的SDK,此補丁的說明如下
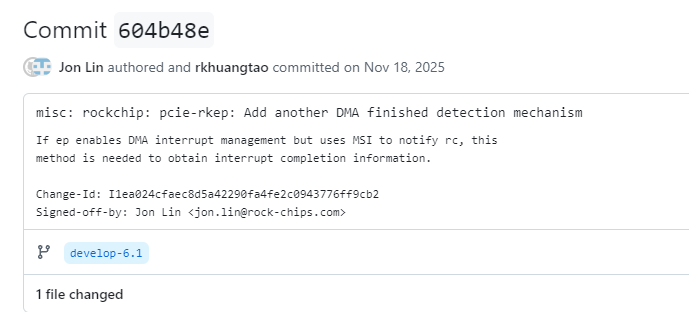
此補丁隻是改了drivers/misc/rockchip/pcie-rkep.c文件,單獨把這個文件拉下來放SDK裡面替換也是可以的。
并确認開啟以下内核配置項:
CONFIG_PCIE_FUNC_RKEP=y
CONFIG_PCIE_DW_DMATEST=y
配置完成後重新編譯内核并燒錄至YY3588開發闆。
2、RK也提供了一個單獨抽出來的rkep驅動文件夾,此文件夾内容如下
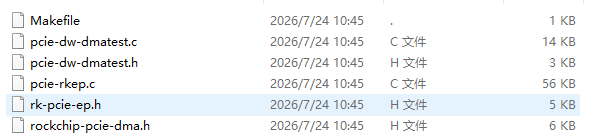
将這幾個文件放到drivers/misc/pcie-rkep目錄下面,然後修改drivers/misc/ Makefile,增加一行
obj-y += pcie-rkep/
然後重新編譯内核,即可得到 drivers/misc/pcie-rkep/pcie-rkep.ko 文件,将此文件通過adb等方式推到闆端,并執行 insmod pcie-rkep.ko
無論采用上述哪種方式,成功加載後,都可以看到如下dmesg信息
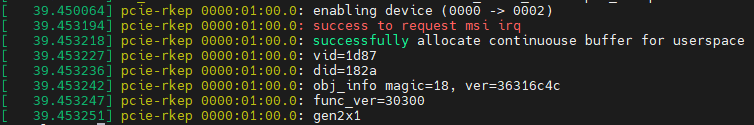
同時/dev目錄下出現 pcie-rkep-XXXX:XX:XX.X節點,其中XXXX:XX:XX.X取決于使用的PCIE端口号。
RKNN3 Runtime配置
解壓rknn3_rk182x_m2_v1.1.0_installer_arm64.tgz後,得到如下内容
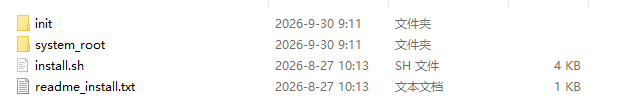
這裡面包含了Linux和Android兩個平台的二進制可執行程序和動态庫。下面僅以Android的部署方式為例說明,Linux是類似的。
1、加載RK182X固件。
RK182X模組沒有存儲器,固件是放在合封的DDR裡面運行的,因此每次上電,都需要主控把它的固件發過去。
固件路徑:system_root/firmware/rknn3_rk1820_ext-m2.img
下載工具:system_root/bin/pcie_upgrade_tool(主控運行Linux和Android時一樣)
将固件和下載工具放到闆上,然後執行
pcie_upgrade_tool uf rknn3_rk1820_ext-m2.img -reset
即可下載。下載時會有如下打印信息
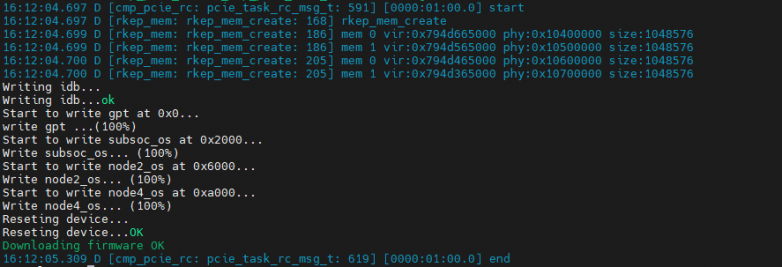
注:下載固件前,RK182X風扇處于最高轉速。下載固件後,RK182X在溫度較低時,風扇會處于低轉速或者不轉,即動态調溫策略會生效。
2、部署動态庫
如果是android系統,動态庫位于system_root/lib/MultiSys/Android/文件夾,把這個文件夾裡面所有文件推到闆端的/vendor/lib64即可
如果是linux系統,動态庫位于system_root/lib/文件夾,把這個文件夾裡面.so後綴的文件推到闆端的/usr/lib64即可
驗證環境是否生效,可将 system_root/bin/rknn-smi(Linux)或 system_root/bin/MultiSys/Android/rknn-smi(Android)推到闆上,執行 rknn-smi -v。如果配置正确,能看到如下打印信息:
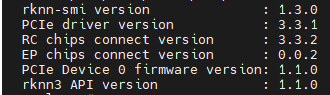
注意 PCIe Device 0 firmware version 是RK182X的固件版本,rknn3 API version 是主控端動态庫版本,二者必須一緻
3、啟動傳輸服務
主控和RK182X之間需要傳遞模型數據等,這裡需要使用到 rknn3_transfer_proxy 工具。
linux的在 system_root/bin/rknn3_transfer_proxy
android的在 system_root/bin/MultiSys/Android/rknn3_transfer_proxy
将這個文件推到闆上,直接執行 rknn3_transfer_proxy &,此時使用 netstat命令可以看到如下兩個端口被打開了

到這裡就完成了runtime的部署。
RK182X大模型對話功能演示
與RK3588/RK3399PRO這些平台一樣,需要把通用模型轉換為RKNN模型後,才能在闆端NPU運行。筆者這裡以RK訓練好的3B模型為例。下載RK提供的模型後,可以得到如下四個文件,把這四個文件推到闆上
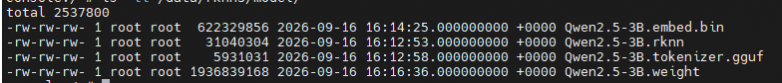
然後需要使用RK提供的一個openAI server端軟件,這樣可以通過openAI接口與之對話。
linux的在 system_root/bin/rkllm3-server
android的在 system_root/bin/MultiSys/Android/rkllm3-server
将這個文件推到闆上,執行
rkllm3-server -m /xxx/Qwen2.5-3B.rknn --weight /xxx/Qwen2.5-3B.weight --vocab /xxx/Qwen2.5-3B.tokenizer.gguf --embed /xxx/Qwen2.5-3B.embed.bin --host 0.0.0.0 --port 8080 -c 768 --n_predict 512 --repeat-penalty 1.1 --presence-penalty 1.0 --frequency-penalty 1.0 --top-k 1 --top-p 0.8 --temp 0.8
這些參數的定義如下
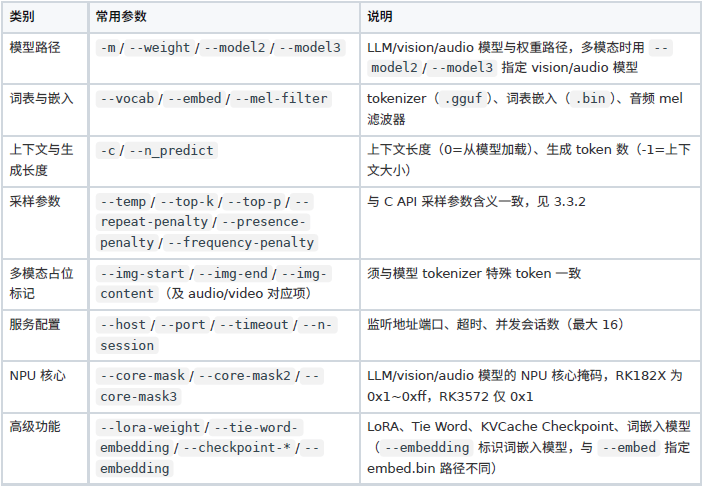
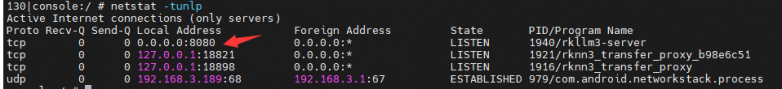
執行之後,可以用netstat看到有如下端口被打開了
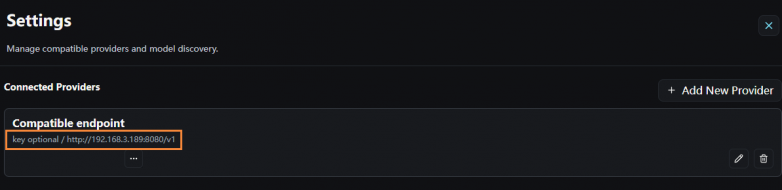
部署完成後,可以使用Navi這款工具與RK3588上面開放出來的openAI兼容端口連接,Navi的配置如下所示,IP填入YY3588闆子的IP,PC要跟闆子在同一局域網。
然後發起對話
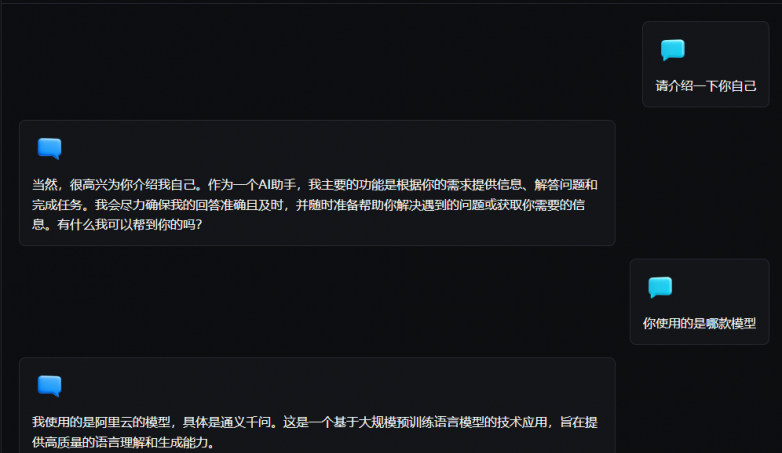
對話之後,在logcat日志裡面,可以看到其運行耗時,消耗的token等信息
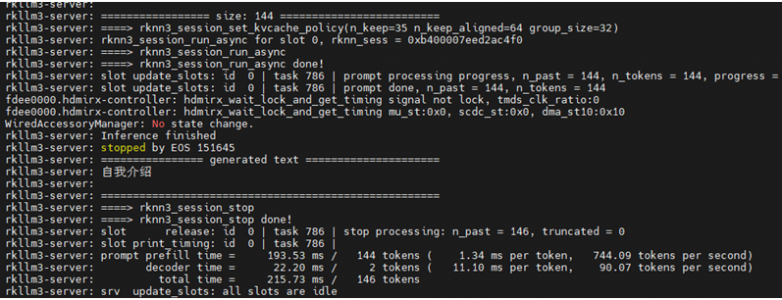
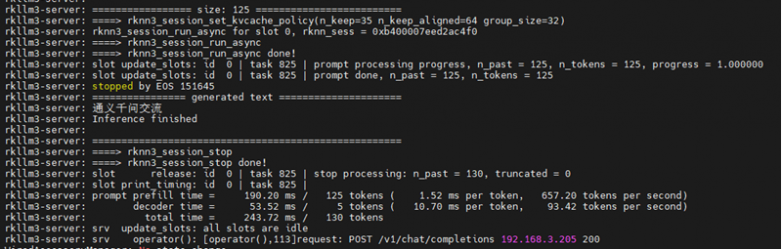
從日志中可以看到,在這個 RK3588 + RK1828 平台上,運行 3B 模型,預填充 prompt prefill 速度高達 700+ tokens/秒,總耗時極低。而筆者此前測試過,在 RK3588 平台上,運行 1.5B 模型,隻能達到 60 tokens/秒左右的速度。相比之下,RK的新架構非常适合跑大模型,而RK3588這種處理器自帶的NPU在面對大模型時确實存在算力瓶頸。
結語
本文從硬件連接、系統配置、驅動加載、軟件部署到最終的推理性能驗證,完整記錄并分享了在RK3588(YY3588)平台上适配RK1828 M.2 AI協處理器的全過程。
通過實測數據可以直觀地看到,RK3588與RK1828的“主控+協處理器”異構架構帶來了顯著的性能飛躍。在運行3B參數規模的大模型時,RK1828憑借其20TOPS的專用NPU算力與5GB高帶寬DRAM,推理速度快,無明顯卡頓感覺,徹底解決了RK3588自帶6TOPS NPU在運行大模型時推理速度緩慢、難以滿足實時性需求的痛點。
随着端側AI向更大參數量、更高實時性方向演進,RK1828 M.2模組以其标準化的接口、即插即用的算力擴展能力,為邊緣計算設備提供了一條極具性價比的升級路徑。未來,我們期待基于該異構平台,進一步探索多模态大模型、端側Agent等更複雜的應用場景,充分釋放邊緣AI的潛力。
免責聲明:本文僅代表作者個人觀點,與每日科技網無關。其原創性以及文中陳述文字和内容未經本站證實,對本文以及其中全部或者部分内容、文字的真實性、完整性、及時性本站不作任何保證或承諾,請讀者僅作參考,并請自行核實相關内容。
本網站有部分内容均轉載自其它媒體,轉載目的在于傳遞更多信息,并不代表本網贊同其觀點和對其真實性負責,若因作品内容、知識産權、版權和其他問題,請及時提供相關證明等材料并與我們聯系,本網站将在規定時間内給予删除等相關處理.