宇樹于9月14日發布G1+,集中升級了機器人的感知與運動能力。
頸部增加2個自由度,視覺系統升級為雙目相機、廣角單目相機和3D激光雷達;肩部與腰部電機的峰值扭矩提升一倍以上,發熱量降低約70%。遠場拾音系統升級為前4後2的六麥克風陣列,支持聲源定位與降噪。頭頂新增5個觸摸點,背部增加DC 54.6V/5.7A外部供電接口,可支持持續供電運行。六項升級均集中在硬件,含稅售價為9.5萬元。
身體越來越像人。裝在裡面那顆腦子,這次一個字沒提。
模型的事,四天前已經公布。9月10日,宇樹發布新一代通用人形機器人基礎模型UnifoLM-WLA-1.0.其中WLA是World-Language-Action,即世界-語言-動作。模型規模為6B;配套的UnifoLM-ER-1使用超過500萬條具身推理樣本,WLA模型使用約2500小時真機數據,一個模型覆蓋64項任務,包括10項全身操作和54項桌面操作。9月11日,首批權重上線。
一具身體挂價簽,一顆腦子挂許可證。
9 月 7 日晚上,一段 38 秒的視頻。畫面裡沒有遙控器,沒有人舉着 VR 頭顯。一台 G1 站在場地中間,人類拳手出拳,它雙拳收到胸前格擋;一記鞭腿掃過來,它退後半步,穩住,回身還了一拳。視頻上打了四個字:全程實拍,無加速。
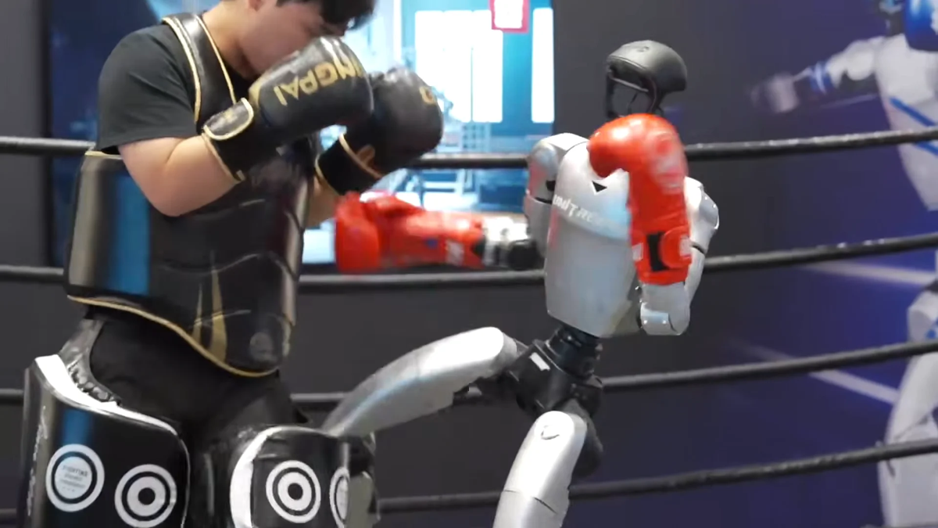
圖注:9 月 7 日演示畫面,場地裡沒有遙控器,也沒有 VR 頭顯。圖片來源:宇樹科技官方演示視頻
宇樹把這場演示稱作全球首次由世界模型實時驅動的全自主人形機器人格鬥,背後是另一套模型 UnifoLM-X2-1.0.
這三次發布集中在一周内:先用格鬥演示實時決策能力,再開放新一代模型,随後發布升級後的機器人本體。
01.先打一場,三天後再開源
先把時間線擺出來。
2025 年 9 月,UnifoLM-WMA-0 開源,WMA 是 World-Model-Action,核心詞是世界。它的任務是把機器人動完之後世界會怎麼變預測出來,可以當仿真引擎造訓練數據,也可以接上動作頭增強決策。
2026 年 1 月,UnifoLM-VLA-0 開源,VLA 是 Vision-Language-Action,核心詞換成動作。底座換到 Qwen2.5-VL,在 G1 上用一套策略跑通 12 類複雜操作任務。
2026 年 9 月,宇樹發布UnifoLM-WLA-1.0.WLA是World-Language-Action,即世界-語言-動作,指向世界建模、語言理解與動作生成的統一。
把三個名稱放在一起,可以看出宇樹這一年的技術路線:先建模世界變化,再生成機器人動作,最後把世界變化預測、語言理解和動作生成納入統一模型。
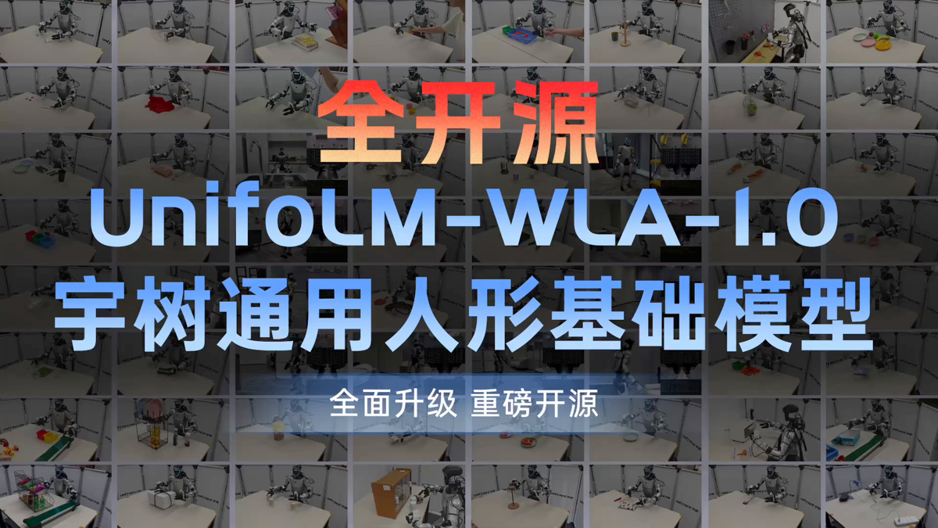
圖注:9 月 10 日宇樹發布的開源主視覺,背景是官方演示裡的任務畫面。圖片來源:宇樹科技官方項目頁
宇樹将9月發布的新模型命名為WLA-1.0.WLA是World-Language-Action,即世界-語言-動作,與前文所述統一世界建模、語言推理和動作生成的技術方向一緻。
9 月 7 日那場格鬥用的 X2-1.0.沒有出現在這批開源清單裡。
02.會認出杯子,不等于會伸手
要理解 WLA 想解決什麼,得先知道 VLA 卡在哪。
過去兩年機器人的視覺能力進展很快,能認出桌上是個杯子,能認出椅子和門。可認出和動手之間隔着一道溝。
識别杯子,與判斷杯子距桌沿多遠、機械臂應從哪個角度接近、動作是否會碰倒旁邊的水瓶,是兩種不同層次的能力。這種感知與動作之間的落地差距可稱為grounding gap。視覺語言模型從互聯網圖文中學到的知識,仍需經過具身數據訓練才能轉化為可靠的物理動作。
宇樹這次的答卷分兩層。第一層是同步亮相的具身推理模型 UnifoLM-ER-1.4B 參數,底座是開源的 Qwen3-VL-4B,用了超過 500 萬條具身推理樣本,覆蓋圖像點預測、物體檢測、多圖推理、2D 軌迹預測、3D 物體檢測、多圖空間問答六類任務。
在16項多模态感知與理解基準中,UnifoLM-ER-1有7項領先表中參評的開源模型:RefSpatial-Bench、Where2Place、PixMo-Point、BLINK、EmbSpatial、RoboSpatial和VSR。
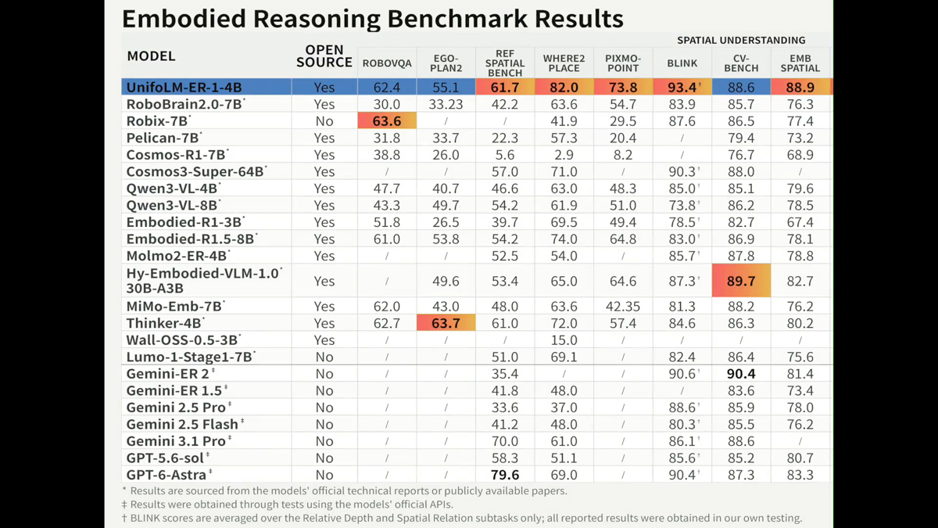
圖注:官方演示視頻裡的成績表,UnifoLM-ER-1-4B 排在第一行。按表格腳注,各家數據來自模型官方技術報告、公開論文,或者用模型官方 API 自測;BLINK 隻取其中兩個子任務的平均。圖片來源:宇樹科技 UnifoLM-WLA-1.0 官方演示視頻
以其中兩項為例:物體擺放預測Where2Place得分82.0.空間關系理解VSR得分88.1.兩項基準都涉及機器人執行動作前的空間判斷,例如目标位置能否放置物體、機械臂的運動是否會與周圍物體發生幹涉。
這些分數需要結合評測方式理解。表中數據來自各模型的技術報告、公開論文和API測試,BLINK也隻統計兩個子任務,因此并非在統一模型版本、推理設置和評測流程下完成的橫向比較。
03.世界模型走了條省錢的路
第二層是這套模型裡最有意思的地方。
VLA 之後,行業裡冒出一條新路線,叫 WAM,World-Action Model,世界-動作模型。思路是讓機器人先學會預測世界怎麼變,再從變化裡推出動作。這個方向更接近人的直覺:人要挪走一個杯子,腦子裡會先過一遍杯子挪開後桌面變成什麼樣。
WAM通常需要生成完整的未來畫面,逐幀預測後續變化。在一張512×512像素的圖像中,大量背景區域與當前任務無關,完整視頻生成仍會為這些區域分配計算量。
UnifoLM-WLA-1.0不生成完整的未來畫面,而是隻預測未來會發生變化的區域。
做法是,用光流從前後兩幀裡提取出真正發生變化的區域,再用 VQ-VAE 把這片連續變化壓成固定長度的離散 token,然後訓練模型:給它當前畫面加任務描述,直接輸出未來會變的區域。宇樹管這個叫 Dynamic Region,動态區域。
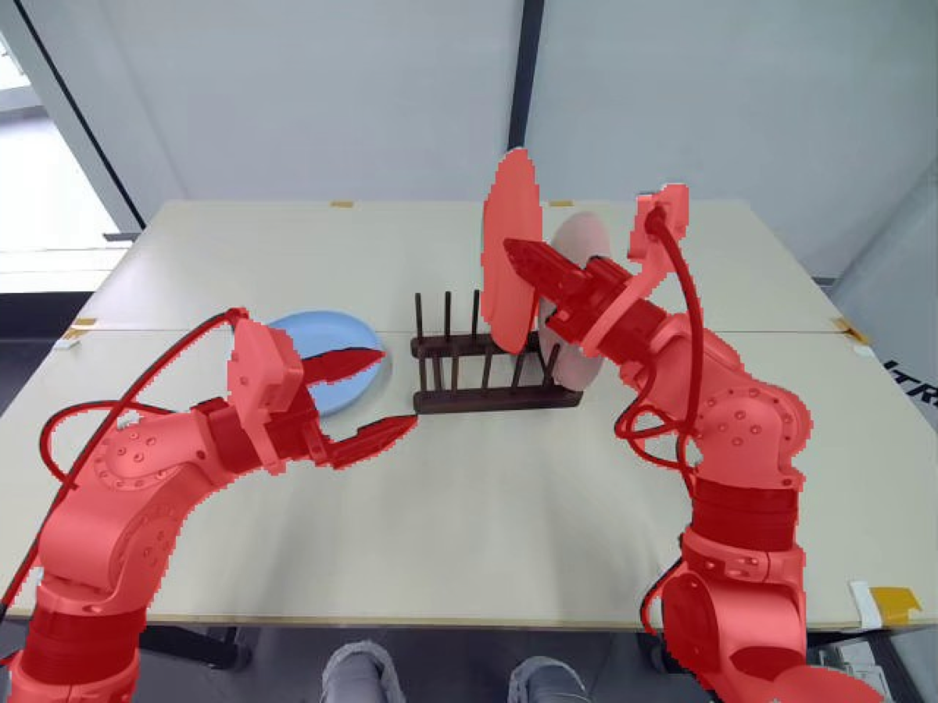
圖注:紅色區塊表示模型預測的未來動态區域,圖中其餘部分未被标記為動态區域。圖片來源:宇樹科技官方項目頁
疊毛巾,真正會變的隻有毛巾本身,加上它被挪走後露出來的那塊桌面。房間裡其他像素紋絲不動。
官方把這條路總結成 interaction-centric world modeling,以交互為中心的世界建模。說人話就是,與其畫一張模糊的全景未來,不如把哪兒會變算準。前者好看,後者有用。
這種設計不追求還原完整未來畫面,而是把預測目标集中到與交互相關的區域,從而減少對無關背景的建模。
04.把動作切成詞,讓全身說同一種語言
光會看不夠,動作還得能被模型統一表達。
不同身體部位和末端執行器常采用不同的動作表示與控制模塊。腿部行走、機械臂運動和手部抓取的控制目标并不相同,更換末端執行器還會改變動作空間的維度和語義,因此統一建模并不容易。
宇樹的做法是把動作也切碎。
它把機器人的動作拆成三段:末端執行器的位姿、手部關節、下半身關節。三段各訓一個殘差向量量化模型,把連續軌迹編碼成離散的動作 token。三組 token 按共享時間步對齊,一起送進視覺語言模型。
手部精細動作、末端軌迹和下肢運動分别被編碼為離散token,并按共享時間步對齊後輸入視覺語言模型。模型由此可以像預測語言token一樣預測動作token。
同一模型聯合生成末端位姿、手部關節和下肢關節的動作,實現全身協同控制。
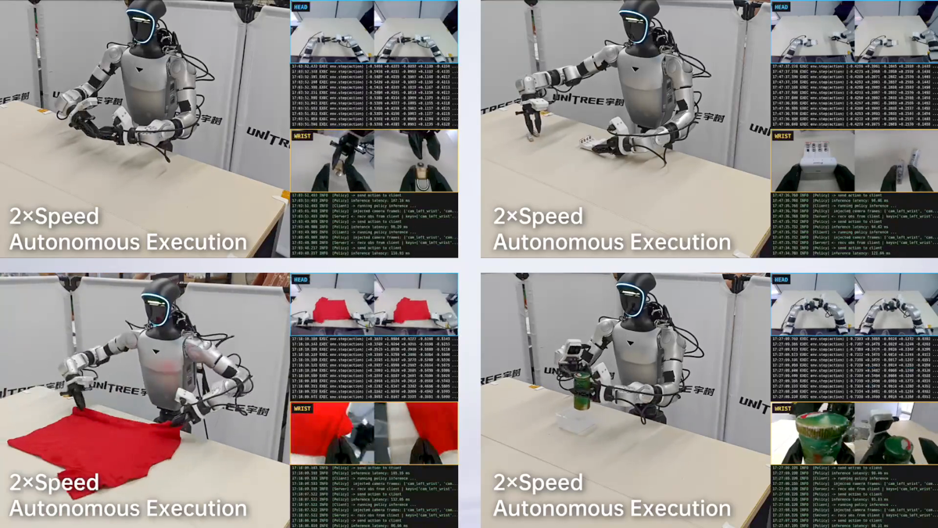
圖注:官方演示裡的桌面任務,畫面标注 2 倍速自主執行,右上和右下分别是頭部與腕部相機的實時畫面。圖片來源:宇樹科技 UnifoLM-WLA-1.0 官方演示視頻
這些模塊共同構成主幹網絡UnifoLM-ER-Flow。主幹網絡之上連接MMDiT動作專家,用于把多模态表征解碼為連續動作指令。
主幹網絡負責多模态感知與理解,動作專家負責生成連續動作。這樣的模塊分工讓語義建模與動作生成分别由更合适的網絡結構承擔,也為端側部署留下了優化空間。
05.2500 小時真機數據,才是最貴的部分
公開的模型結構可以被研究者借鑒,但高質量真機數據的采集、清洗和标注更難複制。
UnifoLM-WLA-1.0 的訓練數據約 2500 小時,官方點名了兩類來源,宇樹自有開源數據集,以及 BitRobot-HIW-500 這類公開資源。
HIW-500由BitRobot、Hugging Face與宇樹聯合發布,包含500多小時真實家庭場景中的全身遙操作數據。數據使用Unitree G1采集,覆蓋29個機器人自由度;頭部配備立體相機,腕部配備紅外立體相機,并采用CC BY 4.0協議開放。
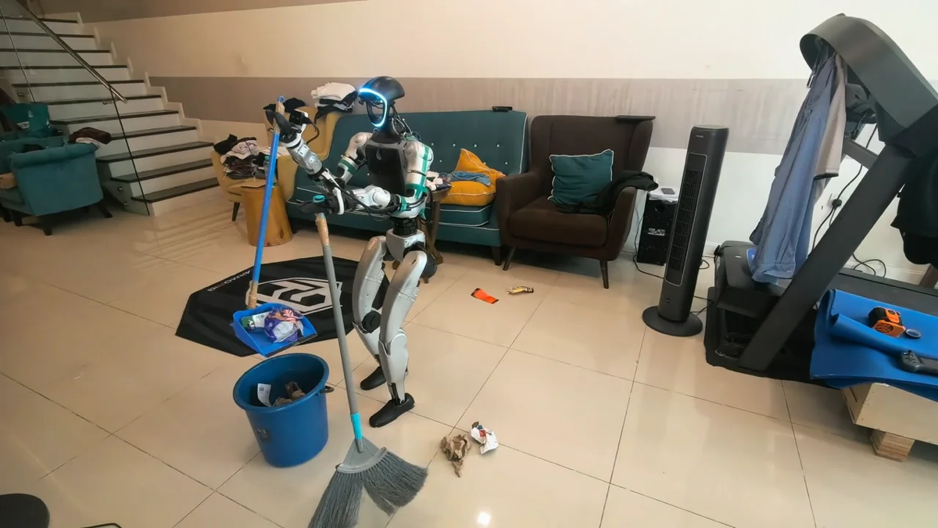
圖注:G1 在真實家庭客廳裡執行清潔任務,這類帶家具、雜物和動線的場景正是全身遙操作數據要覆蓋的對象。
真機數據為什麼貴。仿真裡跑得完美的策略,搬到真機上可能連東西都抓不住,材質、摩擦、光照的每一點差别都會讓動作變形。采真機數據要有人遙操作一台機器人,一小時下來收不回一小時能用的高質量數據,中間還有設備損耗、失敗樣本、清洗标注。
真實物理交互數據仍然稀缺。可用于訓練的合規真實交互數據與通用具身模型所需的數據規模之間仍存在數量級差距。
填這個缺口有兩條路。
一條是宇樹走的這條,用真機遙操作采集,數據準,和本體嚴格對齊,代價是慢,産能取決于手裡有多少台機器人。
另一條是拿人類第一視角視頻來學。9 月 9 日發布 PhysBrain 1.5 的深度機智走的是這條,用全景設備采集人的日常操作視頻,再把人的動作轉換到機器人上。數據便宜、量大,代價是要跨過人和機器人的形态差異。
真機遙操作數據與人類第一視角視頻各有優勢:前者與機器人本體嚴格對齊,但采集成本高;後者規模更大、成本更低,但需要解決人類動作向機器人動作遷移的問題。實際訓練可以根據任務需要組合兩類數據。
06.感知跑分之外,還要看真機任務成功率
最後說這套模型還沒有證明的部分。
同一個UnifoLM-WLA-1.0模型覆蓋64項任務,包括10項全身操作和54項桌面操作。
這件事的價值不在數量,難點在一個。同一套參數,上要管手指的精細動作,下要管全身的移動和平衡,任務之間還不能打架。過去每個任務訓一套模型,邊際成本壓不下來。
邊界也得看清。
64 項任務全在宇樹自己的 G1 上測,換成别的品牌機器人行不行,還沒有數據。前面那 7 項第一,測的也偏向空間理解,屬于眼睛的考試,跟真機操作成功率是兩回事。
感知與空間推理基準衡量的是模型理解環境的能力,不能替代真機任務成功率。分布外任務和新本體上的性能通常會下降,跨任務、跨場景和跨本體泛化仍是具身模型需要解決的問題。
截至9月14日,可下載内容包括具身推理模型、主幹網絡權重和挑戰賽數據集、全身遙操作數據集;後訓練代碼、UnifoLM-WLA-Base權重仍列在後續開放計劃中。
回到那場擂台
格鬥是最難的場景,也是最取巧的場景。
格鬥場景對實時反應、物理判斷和動态交互提出了很高要求,系統需要在數百毫秒内完成感知、預測、決策和控制,并在受到沖擊後迅速恢複平衡。但該演示的邊界也很明确:對手動作和場地條件相對受控,不能單獨證明機器人在開放環境中的泛化能力。
這段演示說明系統能夠在特定場地和對抗條件下完成實時閉環動作,但還不足以說明其長期穩定性和開放環境泛化能力。
從可行走向可用,還需要回答幾個具體問題:輕量世界模型能否處理長尾情況,動作token化能否跨越本體差異,約2500小時真機數據能否支撐更廣泛的任務泛化。研究者可以在許可證允許的範圍内下載已開放的權重和數據進行驗證。
宇樹創始人王興興在世界機器人大會上給過一把尺子:機器人在 80% 的陌生場景裡,僅憑一句語音或文字指令完成 80% 的任務,具身智能才算迎來自己的ChatGPT 時刻。他給的時間是快則兩三年,慢則五到十年。
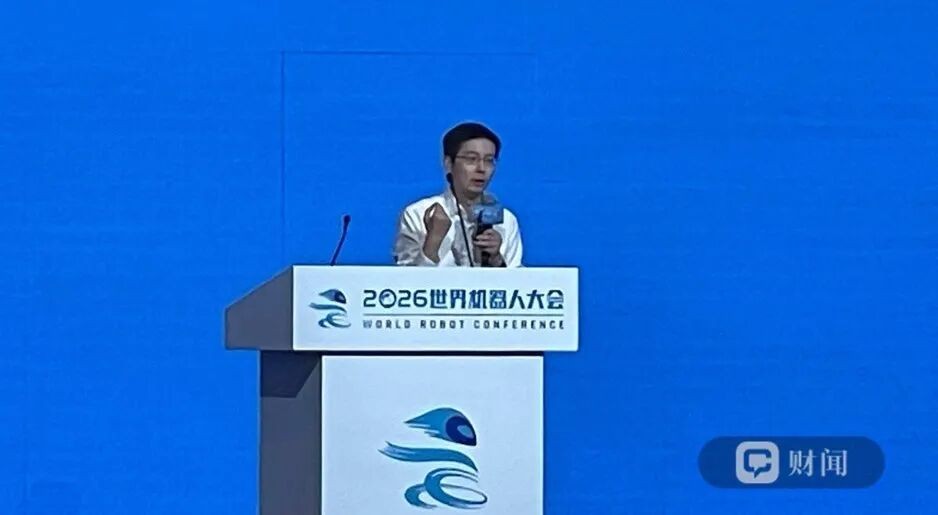
圖注:王興興在 2026 世界機器人大會主論壇發表演講《從展品到産品:人形機器人産業的下一個十年》。
接下來更值得關注的是開放環境中的任務成功率、跨本體泛化能力,以及長時間運行的穩定性。(機器人大講堂)
免責聲明:本文僅代表作者個人觀點,與每日科技網無關。其原創性以及文中陳述文字和内容未經本站證實,對本文以及其中全部或者部分内容、文字的真實性、完整性、及時性本站不作任何保證或承諾,請讀者僅作參考,并請自行核實相關内容。
本網站有部分内容均轉載自其它媒體,轉載目的在于傳遞更多信息,并不代表本網贊同其觀點和對其真實性負責,若因作品内容、知識産權、版權和其他問題,請及時提供相關證明等材料并與我們聯系,本網站将在規定時間内給予删除等相關處理.